import sys, os
sys.path.append(os.pardir)
from common.functions import *
from common.gradient import numerical_gradient
import numpy as np
class TwoLayerNet:
    def __init__(self,input_size,hidden_size,output_size,weight_init_std=0.01):

        # 1
        self.params = {}

        # 2
        self.params["W1"] = weight_init_std * np.random.randn(input_size,hidden_size)
        self.params ["W2"] = weight_init_std * np.random.randn(hidden_size,output_size)

        # 3
        self.params["b1"] = np.zeros(hidden_size)
        self.params["b2"] = np.zeros(output_size)

    def predict(self,x):

        # 1
        W1,W2 = self.params["W1"], self.params["W2"]
        b1, b2 = self.params["b1"],self.params["b2"]

        # 2
        a1 = np.dot(x,W1) + b1
        z1 = sigmoid(a1)
        a2 = np.dot(z1,W2) + b2
        y = softmax(a2)

        return y

    def loss(self,x,t):
        # 1
        y = self.predict(x)

        # 2
        return cross_entropy_error(y,t)

    def accuracy(self,x,t):
        # 1
        y = self.predict(x)

        # 2
        y = np.argmax(y,axis=1)
        t = np.argmax(t,axis=1)

        # 3
        accuracy = np.sum(y ==t) / float(x.shape[0])
        return accuracy

    def numerical_gradient(self,x,t):
        # 1
        loss_W = lambda W: self.loss(x,t)

        # 2
        grads = {}

        # 3
        grads['W1'] = numerical_gradient(loss_W,self.params['W1'])
        grads['b1'] = numerical_gradient(loss_W,self.params['b1'])
        grads['W2'] = numerical_gradient(loss_W,self.params['W2'])
        grads['b2'] = numerical_gradient(loss_W,self.params['b2'])

        return grads
numerical_gradient() 必要な引数: 入力データ、教師ラベル(正解データ)
このクラスの変数とメソッドを以下にまとめます。
| 変数 | 説明 |
|---|---|
| params | 重みを保存するディクショナリ |
| grads | 勾配を保存するディクショナリ |
| メソッド | 説明 |
|---|---|
| __init__(self,input_size,hidde_size,output_size) | 初期化を行う(入力するデータの数、中間層のニューロンの数、出力層の数を設定する) |
| predict(self,x) | 推論(掛け算)を行う。xはデータ |
| loss(self,x,t) | 損失を求める。xはデータ、tは正解ラベル |
| accuracy(self,x,t) | 予測の精度を求める。 |
# インスタンスの生成
net = TwoLayerNet(input_size=3,hidden_size=4,output_size=2)
# 初期化された(ランダムな)重み
net.params["W1"].shape
(3, 4)
# ランダムなデータを発生させ、予測
x = np.random.rand(10,3)
y = net.predict(x)
y.shape
(10, 2)
# ランダムに正解ラベルを発生させて、勾配を計算
t = np.random.rand(10,2)
grads = net.numerical_gradient(x,t)
import sys, os
sys.path.append(os.pardir)
from dataset.mnist import load_mnist

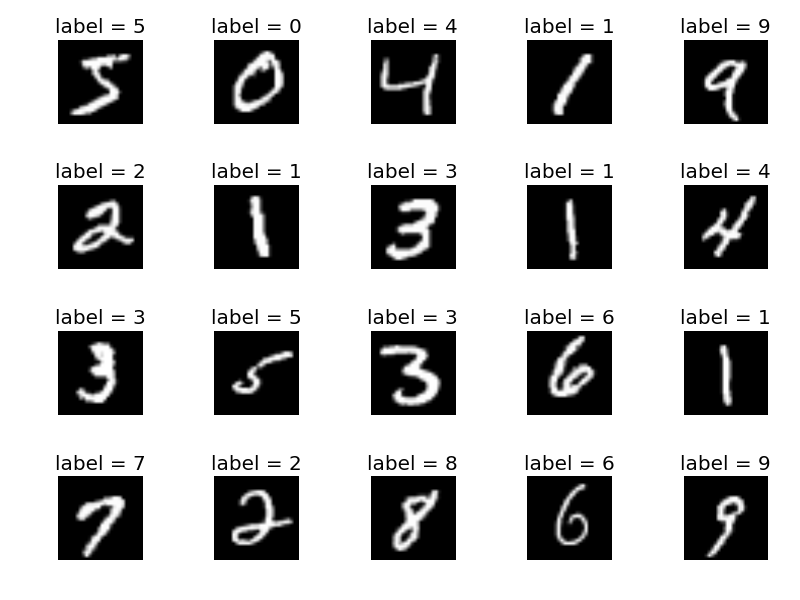
(x_train,t_train),(x_test,t_test) = load_mnist(normalize=True,one_hot_label=True)
print(x_train.shape)
(60000, 784)
train_size = x_train.shape[0]
batch_size = 100
batch_mask = np.random.choice(train_size,batch_size)
x_batch = x_train[batch_mask]
t_batch = t_train[batch_mask]
class TwoLayerNet:

    def __init__(self, input_size, hidden_size, output_size, weight_init_std=0.01):
        # 重みの初期化
        self.params = {}
        self.params['W1'] = weight_init_std * np.random.randn(input_size, hidden_size)
        self.params['b1'] = np.zeros(hidden_size)
        self.params['W2'] = weight_init_std * np.random.randn(hidden_size, output_size)
        self.params['b2'] = np.zeros(output_size)

    def predict(self, x):
        W1, W2 = self.params['W1'], self.params['W2']
        b1, b2 = self.params['b1'], self.params['b2']

        a1 = np.dot(x, W1) + b1
        z1 = sigmoid(a1)
        a2 = np.dot(z1, W2) + b2
        y = softmax(a2)

        return y

    # x:入力データ, t:教師データ
    def loss(self, x, t):
        y = self.predict(x)

        return cross_entropy_error(y, t)

    def accuracy(self, x, t):
        y = self.predict(x)
        y = np.argmax(y, axis=1)
        t = np.argmax(t, axis=1)

        accuracy = np.sum(y == t) / float(x.shape[0])
        return accuracy

    # x:入力データ, t:教師データ
    def num_gradient(self, x, t):
        loss_W = lambda W: self.loss(x, t)

        grads = {}
        grads['W1'] = numerical_gradient(loss_W, self.params['W1'])
        grads['b1'] = numerical_gradient(loss_W, self.params['b1'])
        grads['W2'] = numerical_gradient(loss_W, self.params['W2'])
        grads['b2'] = numerical_gradient(loss_W, self.params['b2'])

        return grads

    def gradient(self, x, t):
        W1, W2 = self.params['W1'], self.params['W2']
        b1, b2 = self.params['b1'], self.params['b2']
        grads = {}

        batch_num = x.shape[0]

        # forward
        a1 = np.dot(x, W1) + b1
        z1 = sigmoid(a1)
        a2 = np.dot(z1, W2) + b2
        y = softmax(a2)

        # backward
        dy = (y - t) / batch_num
        grads['W2'] = np.dot(z1.T, dy)
        grads['b2'] = np.sum(dy, axis=0)

        dz1 = np.dot(dy, W2.T)
        da1 = sigmoid_grad(a1) * dz1
        grads['W1'] = np.dot(x.T, da1)
        grads['b1'] = np.sum(da1, axis=0)

        return grads
# インスタンスの生成
net = TwoLayerNet(input_size=784,hidden_size=100,output_size=10)
# ハイパーパラメター
iters_num = 10000
train_size = x_train.shape[0]
batch_size = 100
learning_rate = 0.1
# ミニバッチ学習の実装

# 記録保存のためのリスト
loss_list = []

for i in range(iters_num):
    # ミニバッチの取得
    batch_mask = np.random.choice(train_size,batch_size)
    x_batch = x_train[batch_mask]
    t_batch = t_train[batch_mask]

    # 勾配の計算
    grad = net.gradient(x_batch,t_batch)

    # パラメータの更新
    for key in ("W1","b1","W2","b2"):
        net.params[key] -= learning_rate * grad[key]

    # 経過の記録
    loss = net.loss(x_batch,t_batch)
    loss_list.append(loss)
# 損失関数の可視化
import matplotlib.pyplot as plt
%matplotlib inline

right = np.arange(1,10001,1)
plt.plot(right,loss_list)
[<matplotlib.lines.Line2D at 0x7adc64bbb560>]

net.accuracy(x_test,t_test)
0.9472