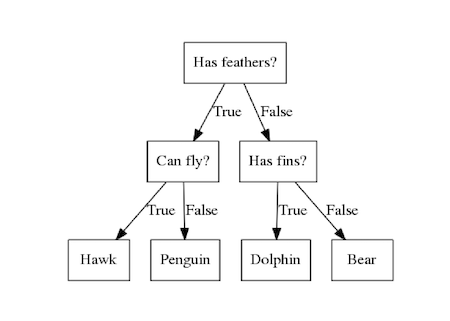
mglearn.plots.plot_tree_progressive()


# データの読み込み
import pandas as pd
data = pd.read_csv("../DATA01/TALL030302.csv",index_col=0)
data.head()
| sents | words | wps | ttr | score | |
|---|---|---|---|---|---|
| JPN002 | 25 | 392 | 15.680000 | 0.725000 | 3 |
| JPN004 | 18 | 288 | 16.000000 | 0.558333 | 3 |
| JPN006 | 26 | 548 | 21.076923 | 0.716667 | 5 |
| JPN008 | 21 | 332 | 15.809524 | 0.583333 | 3 |
| JPN010 | 18 | 391 | 21.722222 | 0.583333 | 3 |
# モジュールのインポートとモデルの作成
from sklearn.tree import DecisionTreeClassifier

# train_test_splitのインポート
from sklearn.model_selection import train_test_split

# データの分割
X_train,X_test,y_train,y_test = train_test_split(data[["sents","words","wps","ttr"]],data["score"],test_size=0.2,random_state=0)

# インスタンスの生成
clf = DecisionTreeClassifier(max_depth=2)

# 学習
clf = clf.fit(X_train,y_train)

# 予測精度の出力
clf.score(X_test,y_test)
0.48
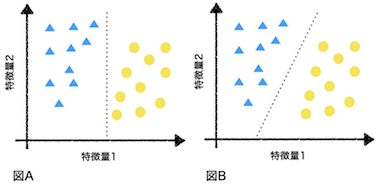
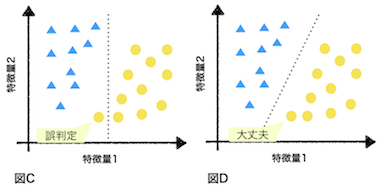
# 決定木による予測で用いたデータと同じデータを使用する。

# モジュールのインポート
from sklearn import svm

# インスタンスの生成
clf = svm.SVC()

# 学習
clf.fit(X_train,y_train)

# 精度の出力
clf.score(X_test,y_test)
0.44