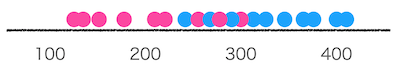
# 模擬試験の点数
D = [110,120,150,190,210,215,240,255,270,280,290,300,305,310,350,370,375,400,405]
# 合否(0が不合格、1が合格)
S = [0,0,0,0,0,0,1,0,1,0,1,0,1,1,1,1,1,1,1]
import pandas as pd
df = pd.DataFrame({"点数":D,"合否":S})
df
| 点数 | 合否 | |
|---|---|---|
| 0 | 110 | 0 |
| 1 | 120 | 0 |
| 2 | 150 | 0 |
| 3 | 190 | 0 |
| 4 | 210 | 0 |
| 5 | 215 | 0 |
| 6 | 240 | 1 |
| 7 | 255 | 0 |
| 8 | 270 | 1 |
| 9 | 280 | 0 |
| 10 | 290 | 1 |
| 11 | 300 | 0 |
| 12 | 305 | 1 |
| 13 | 310 | 1 |
| 14 | 350 | 1 |
| 15 | 370 | 1 |
| 16 | 375 | 1 |
| 17 | 400 | 1 |
| 18 | 405 | 1 |


# 模擬試験の点数
D = [110,120,150,190,210,215,240,255,270,280,290,300,305,310,350,370,375,400,405]
# 合否(0が不合格、1が合格)
S = [0,0,0,0,0,0,1,0,1,0,1,0,1,1,1,1,1,1,1]
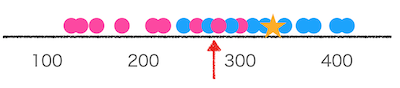
# データのそれぞれの値に関して、赤い矢印を100から410まで5点刻みで動かした場合の予測を算出する
A = []
for i in range(100,415,5):
tmp = []
for j in D:
if j < i:
tmp.append(0)
else:
tmp.append(1)
A.append(tmp)
# 赤い矢印を100から410まで動かしたそれぞれの場合の正解率を算出
R = []
for i in A:
tmp = []
for j,k in zip(i,S):
if j == k:
tmp.append(1)
else:
tmp.append(0)
r = sum(tmp)/len(tmp)
R.append(r)
# 可視化
import matplotlib.pyplot as plt
%matplotlib inline
L = list(range(100,415,5))
plt.plot(L,R)
plt.xlabel("the position of the arrow")
plt.ylabel("accuracy rate")
Text(0, 0.5, 'accuracy rate')
# 交差検証法のパッケージをimport
from sklearn.model_selection import train_test_split
# データを学習データとテストデータに分割
X_train, X_test, Y_train, Y_test = train_test_split(D, S, test_size=0.5,random_state=0)
# 学習データで学習1
A2 = []
for i in range(100,415,5):
tmp = []
for j in X_train:
if j < i:
tmp.append(0)
else:
tmp.append(1)
A2.append(tmp)
# 学習データで学習2
R2 = []
for i in A2:
tmp = []
for j,k in zip(i,Y_train):
if j == k:
tmp.append(1)
else:
tmp.append(0)
r = sum(tmp)/len(tmp)
R2.append(r)
# 最大値を取るindex
R2.index(max(R2))
41
# 最大値を取る赤い矢印の位置
L[41]
305
# テストデータで予測精度の確認
R3 = []
for i in X_test:
if i < 305:
R3.append(0)
else:
R3.append(1)
# 正解率
n = 0
for i,j in zip(R3,Y_test):
if i == j:
n +=1
print(n/len(R3))
0.7